中心極限定理とは
ある母集団から同じ大きさの標本を何度も無作為に取り出し、それぞれの標本について平均値を計算することを考えてみます。
例えば、ある集団から10人を無作為に選んで平均身長を求めます。次に、別の10人を無作為に選んで平均身長を求めます。これを何度も繰り返すと、選ばれる人が異なるため、それぞれの標本平均も少しずつ異なります。このようにして得られた多数の標本平均の分布を「標本平均の標本分布」といいます。
中心極限定理とは、母集団が正規分布でなくても、10人、50人、100人……とサンプルサイズを大きくしていくと、標本平均の標本分布が「母集団の平均を中心とした正規分布」に近づいていくという定理です。
より本質的には、中心極限定理は、独立な確率変数をたくさん足し合わせた「和」の分布が、一定の条件のもとで正規分布に近づいていくことを示しています。標本平均は、この「和」をサンプルサイズで割ったものです。そのため、サンプルサイズが大きくなると、標本平均の分布も正規分布に近づいていきます。
また、標本平均のばらつき(標準誤差)はサンプルサイズが大きくなるほど小さくなります。そのため、サンプルサイズが大きいほど、標本平均は母集団平均の近くに集まりやすくなります。
ここで重要なのは、元の母集団そのものが正規分布になるわけではないということです。正規分布に近づくのは、「標本平均の標本分布」です。
これを数式を使って考えてみます。
独立同分布(iid: independent and identically distributed)に従う確率変数 を考え、その期待値を 、分散を とします。
標本平均
の期待値と分散は、
となります。
したがって、標本平均の標準偏差は、
となります。この標本平均の標準偏差を「標準誤差」といいます。
サンプルサイズ が大きくなるにつれて、標本平均の標本分布は正規分布に近づいていきます。これが中心極限定理です。
重要なのは、元のデータそのものが正規分布になるわけではなく、「標本平均の分布」が正規分布に近づくという点です。
平均値の収束について、少し数式を加えて解説
任意の母集団分布において、その平均を μ、分散を σ2 とします。 この母集団から無作為に抽出された独立標本の平均を X とすると、 標本サイズ n が増加するにつれて、 X の分布は 正規分布 N(μ, σ2/n) に近づきます。
ここで、標本平均の期待値は母集団の平均 μ に等しく、 分散は母集団の分散 σ2 を標本サイズ n で割ったものになります。 標本平均の標準偏差は、母集団の標準偏差 σ を 標本サイズの平方根 √n で割ったものになります。
分布が歪んでいる場合や外れ値が多い場合は、 正確な正規近似を得るために、より大きな n が必要となります。 理論的には、n → ∞ で、 X の分布は 正規分布 N(μ, σ2/n) に近づきます。
平均値の分布を確認
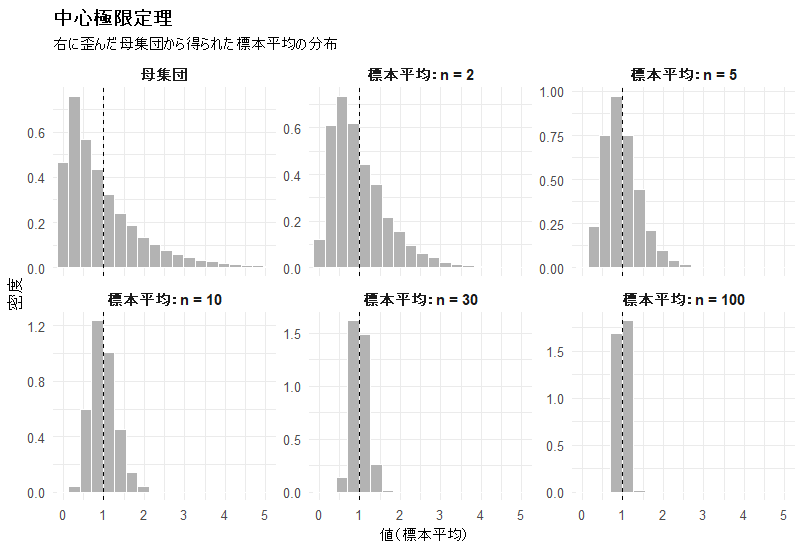
母集団は右に大きく歪んでいます。しかし、この母集団から無作為抽出を繰り返して標本平均を求めると、標本サイズが大きくなるにつれて、標本平均の分布は正規分布に近づいていきます。また、標本サイズが大きくなるほど標本平均のばらつきは小さくなり、母平均の周囲に集中します。この性質を中心極限定理といいます。
Rのコード
#中心極限定理のシミュレーション
#母集団:指数分布(右に歪んだ分布)
library(ggplot2)
library(dplyr)
library(tidyr)
set.seed(123)
#設定
#標本サイズ
sample_sizes <- c(2, 5, 10, 30, 100)
#各標本サイズについて繰り返す回数
n_sim <- 10000
#母集団:指数分布
rate = 1 → 平均 = 1、分散 = 1
rate <- 1
#母集団分布を作成
population <- data.frame(
value = rexp(100000, rate = rate),
group = “母集団”
)
#各標本サイズについて標本平均を10,000個作る
sample_means <- lapply(sample_sizes, function(n) {
means <- replicate(
n_sim,
mean(rexp(n, rate = rate))
)
data.frame(
value = means,
group = paste0(“標本平均:n = “, n)
)
}) %>%
bind_rows()
#母集団と標本平均を結合
plot_data <- bind_rows(
population,
sample_means
)
#パネルの順番を指定
plot_data$group <- factor(
plot_data$group,
levels = c(
“母集団”,
“標本平均:n = 2”,
“標本平均:n = 5”,
“標本平均:n = 10”,
“標本平均:n = 30”,
“標本平均:n = 100”
)
)
#作図
ggplot(plot_data, aes(x = value)) +
geom_histogram(
aes(y = after_stat(density)),
bins = 40,
fill = “grey70”,
color = “white”
) +
facet_wrap(
~ group,
ncol = 3,
scales = “free_y”
) +
#母平均 = 1 を示す
geom_vline(
xintercept = 1,
linetype = “dashed”,
linewidth = 0.7
) +
coord_cartesian(
xlim = c(0, 5)
) +
labs(
title = “中心極限定理”,
subtitle = “右に歪んだ母集団から得られた標本平均の分布”,
x = “値(標本平均)”,
y = “密度”
) +
theme_minimal(base_size = 12) +
theme(
plot.title = element_text(
size = 16,
face = “bold”
),
plot.subtitle = element_text(
size = 12
),
strip.text = element_text(
size = 11,
face = “bold”
)
)
サイコロを使用した実験
二項分布の確率質量関数(probability mass function; PMF)
中心極限定理は、二項分布においても適用されます。 例えば、サイコロを投げて「1」が出た場合を成功とします。 サイコロで「1」が出る確率は 1/6 です。
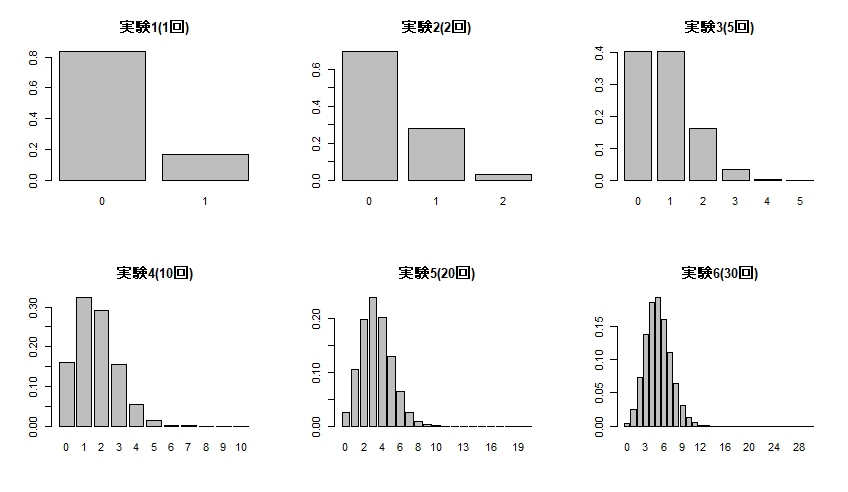
サイコロを振る回数 n を 1回、2回、5回、10回、20回、30回と徐々に増やし、 二項分布を用いて成功回数(1が出る回数)の確率分布を求めます。 ここでは、成功回数を確率変数 X とします。
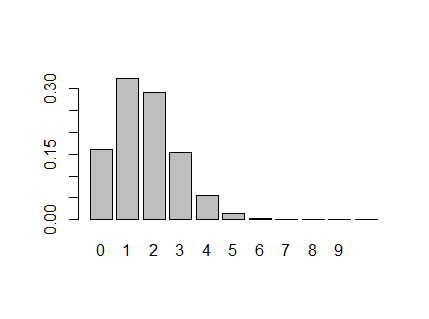
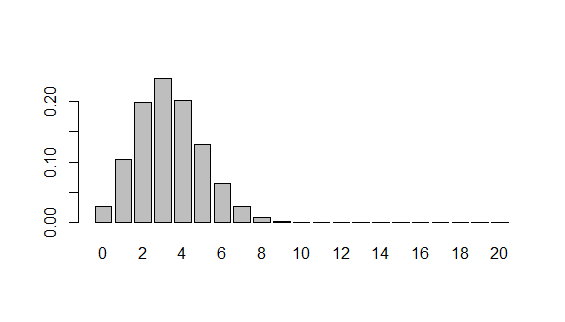
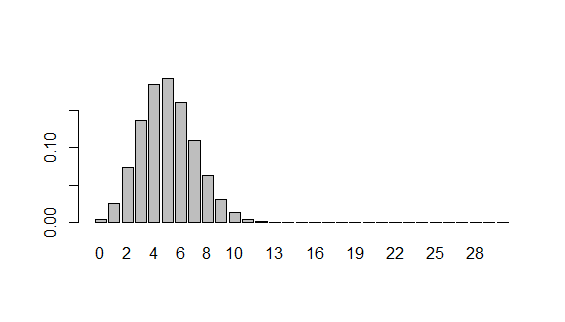
成功回数 X は、二項分布 B(n, 1/6) に従います。 試行回数 n が大きくなるにつれて、 成功回数 X の二項分布は次第に正規分布に近づきます。 この現象は中心極限定理によって説明できます。
なお、「1」が出る確率は 1/6 と比較的小さいため、 試行回数が30回程度ではまだ分布にやや歪みがみられます。 試行回数をさらに増やすと、より正規分布に近づいていきます。
実験1) コインを 1回 投げた場合、表になる確率と裏になる確率
サイコロで1が出る確率 = 1/6, 試行回数 = 1回, 成功回数 = {0, 1}回
π = 1/6, n = 1, k = {0, 1}
1回投げて1の出る確率は0.17
単純に1/6の計算ですが、確率質量関数を使用する場合は、以下のRのコードをご覧ください
Rのコード
#空のベクトル k() を作成・・・二項分布の成功回数に該当する
k <- c()
#成功回数0回(表が0回=裏)、成功回数1回(表が1回)
#k <- c(0, 1)を作成
for(i in 0: 1)
k <- c(k, i)
#コインを投げた回数(試行回数)
n <- 1
#コインの表確率
pi <- 1/6
#裏になる確率と表になる確率
p1 <- choose(1, k)*(pi^k)*(1 – pi)^(n – k)
print(p1)
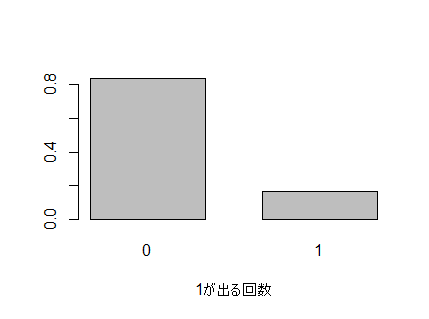
Rのコード
#表が0枚, 1枚となる確率のグラフ
bar1 <- barplot(P1, space=c(0.5), names.arg=c(0, 1), xlab=”1が出る回数”)
実験2) コインを 2回 投げた場合に、表が 0回, 1回, 2回 となる確率
表が出ない確率0.69、表が1回出る確率0.28、2回出る確率0.03
Rのコード
#空のベクトル k() を作成・・・二項分布の成功回数に該当する
k <- c()
#成功回数0回(表が0回=裏)、成功回数1回(表が1回)
#k <- c(0, 1)を作成
for(i in 0: 2)
k <- c(k, i)
#コインを投げた回数(試行回数)
n <- 2
#コインの表確率
pi <- 1/6
#裏になる確率と表になる確率
p2 <- choose(n, k)*(pi^k)*(1 – pi)^(n – k)
round(print(p2), 2)
#binom関数を使えばもっと簡単です
probabilities <- dbinom(x=k, size=n, prob=pi)
print(probabilities)
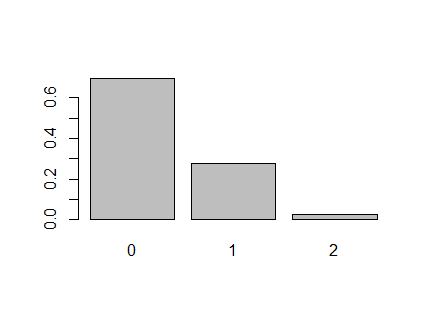
Rのコード
bar2 <- barplot(P2, names.arg=c(0, 1, 2))
実験3) コインを 5回 投げた場合に、表が0回, 1回, …, 5回 となる確率
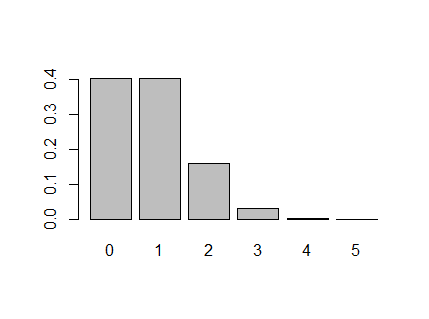
0回0.40、1回0.40、2回0.16、3回0.03、4回0.00、5回0.00
Rのコード
n <- 5
k <- c()
for(i in 0: n)
k <- c(k, i)
pi <- 1/6
p5 <- dbinom(x=k, size=n, prob=pi)
round(p5, 2)
bar5 <- barplot(p5, names.arg=c(0:n))
実験4) コインを 10回 投げた場合に、表が0回, 1回, …, 10回 となる確率
結果は以下のコードを実行してください
Rのコード
n <- 10
k <- c()
for(i in 0: n)
k <- c(k, i)
pi <- 1/6
p10 <- dbinom(x=k, size=n, prob=pi)
round(p10, 2)
bar10 <- barplot(p10, names.arg=c(0:n) )
実験5) コインを 20回 投げた場合に、表が0回, 1回, …, 20回 となる確率
結果は以下のコードを実行してください
Rのコード
n <- 20
k <- c()
for(i in 0: n)
k <- c(k, i)
pi <- 1/6
p20 <- dbinom(x=k, size=n, prob=pi)
round(p20, 2)
bar20 <- barplot(p20, names.arg=c(0:n))
実験6) コインを30回投げた場合に、表が0回, 1回, …, 30回 となる確率
Rのコード
n <- 30
k <- c()
for(i in 0: n)
k <- c(k, i)
pi <- 1/6
p30 <- dbinom(x=k, size=n, prob=pi)
round(p30, 2)
bar30 <- barplot(p30, names.arg=c(0:n))
実験のグラフのまとめ
Rのコード
par(mfrow = c(2,3))
barplot(p1, names.arg=c(0:1), main=”実験1(1回)”)
barplot(p2, names.arg=c(0:2), main=”実験2(2回)”)
barplot(p5, names.arg=c(0:5), main=”実験3(5回)”)
barplot(p10, names.arg=c(0:10), main=”実験4(10回)”)
barplot(p20, names.arg=c(0:20), main=”実験5(20回)”)
barplot(p30, names.arg=c(0:30), main=”実験6(30回)”)
par(mfrow = c(1, 1))
ちにみに10000回投げた場合・・・
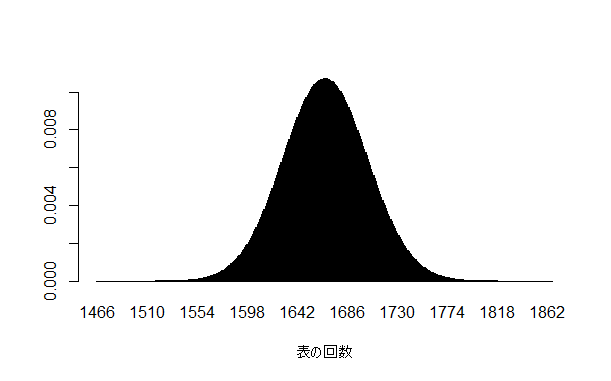
Rのコード
a <- 1666-200
b <- 1666+200
k <- c()
for(i in a: b)
k <- c(k, i)
n <- 10000
pi <- 1/6
prob10000 <- dbinom(x=k, size=n, prob=pi)
barplot(prob10000, names.arg=c(a: b), xlab=”表の回数”)
参考) 西内 啓; 統計学が最強の学問である[実践編]—データ分析のための思想と方法, ダイヤモンド社, 2014