分割表の基礎
分割表を作成します。
results = 検査結果(positive = 陽性、negative=陰性)
affected = 罹患(0=無し、1=あり)
results <- c(rep("negative",70), rep("positive",75))

affected <- c(
  rep("no", 45),
  rep("yes", 25),
  rep("yes", 8),
  rep("no", 67)
)

tab <- xtabs(~ results + affected)
print(tab)> print(tab)
affected
results no yes
negative 45 25
positive 67 8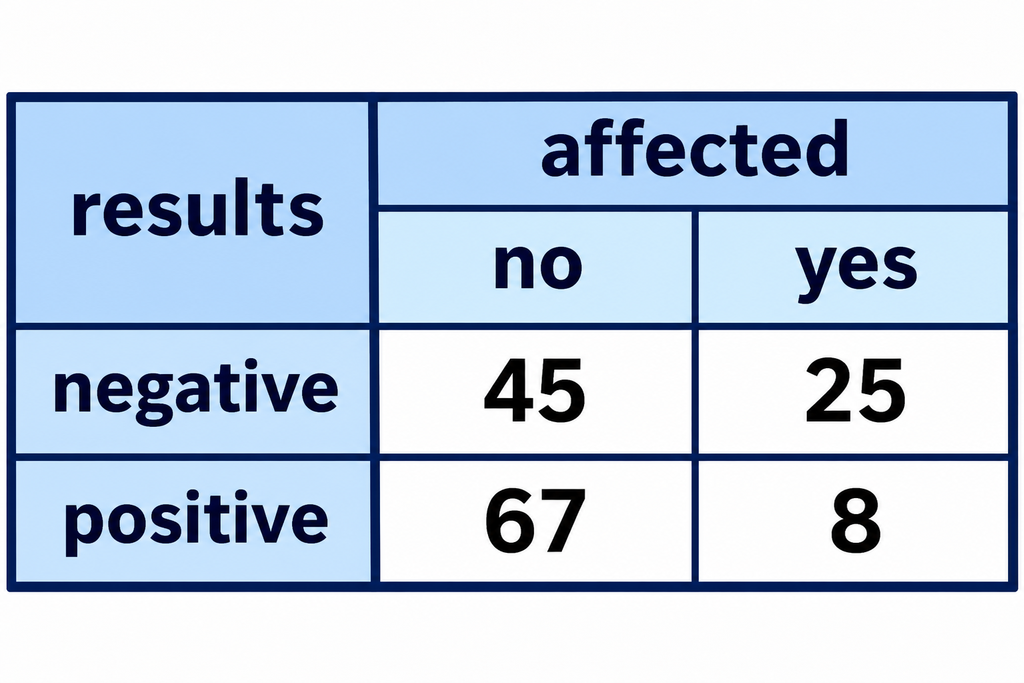
診断検査の説明で一般的に使われる配列は以下の通りです。
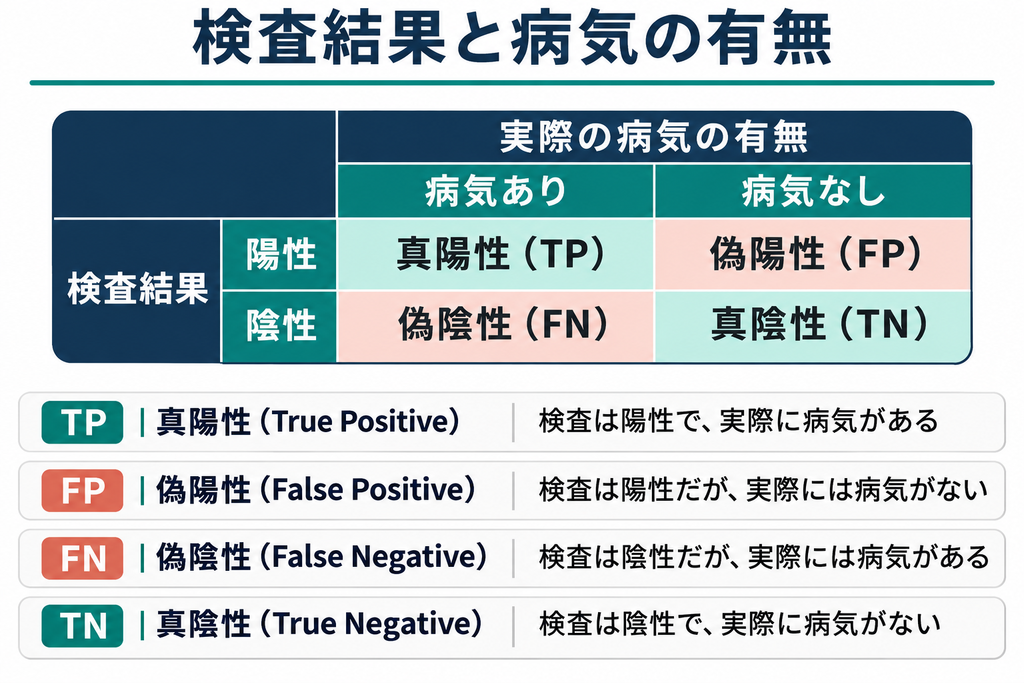
配列を変更したい場合
# 解析用の表
tab <- xtabs(~ results + affected)

# 表示用:行と列の順番を指定
tab_display <- tab[
  c("positive", "negative"),
  c("yes", "no")
]

print(tab_display)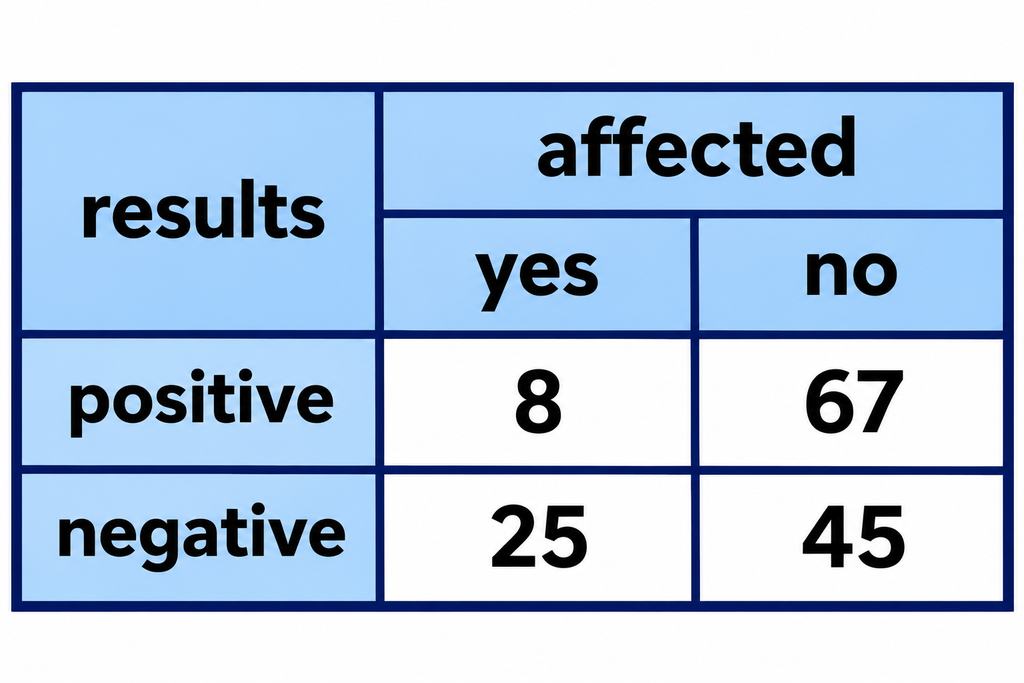
これで馴染みのある並び方になりました
レベルの確認、基準の変更
Rでは、表の行や列の順番を変えることと、解析で「どのカテゴリーを比較の基準にするか」を指定することを区別する必要があります。
例えば、陽性と陰性を比較するとき、陽性を基準にすれば「陽性に対して陰性はどうか」、陰性を基準にすれば「陰性に対して陽性はどうか」を評価します。基準カテゴリーによって、結果を読む方向が変わります。
Rでは関数によって、因子の水準の順序や表の配置の扱いが異なります。見た目だけで判断せず、使用する関数がどのカテゴリーを基準にしているかを確認することが大切です。
factor() 関数は名義変数をカテゴリカル変数(因子型変数)に変換し、データのカテゴリーは「水準」として定義されます。levels() 関数で表示されるカテゴリカル変数の水準のうち、最初に表示されるカテゴリーがデフォルトで基準カテゴリー(参照カテゴリー)となり、統計モデルでの比較の基点として機能します。relevel() 関数や factor() 関数の levels 引数を使用することで、レベルの順序を指定し、基準カテゴリーを変更することが可能です。
それでは、因子(factor)の基準カテゴリーを変更する方法を確認しましょう。`relevel()`を使うと、指定したカテゴリーを最初の水準にできます。
レベルの確認
results <- factor(results)
affected <- factor(affected)
levels(results)
levels(affected)> results <- factor(results)
> affected <- factor(affected)
> levels(results)
[1] "negative" "positive"
> levels(affected)
[1] "no" "yes"先頭に記載されている方がデータの基準カテゴリーとなります。検査結果の基準は”negative”、罹患の基準は”no”になっています。
基準カテゴリを変更する方法(relevel)
results <- relevel(results, "positive")
affected <- relevel(affected , "yes")
levels(results)
levels(affected)> levels(results)
[1] "positive" "negative"
> levels(affected)
[1] "yes" "no" 分割表を作成
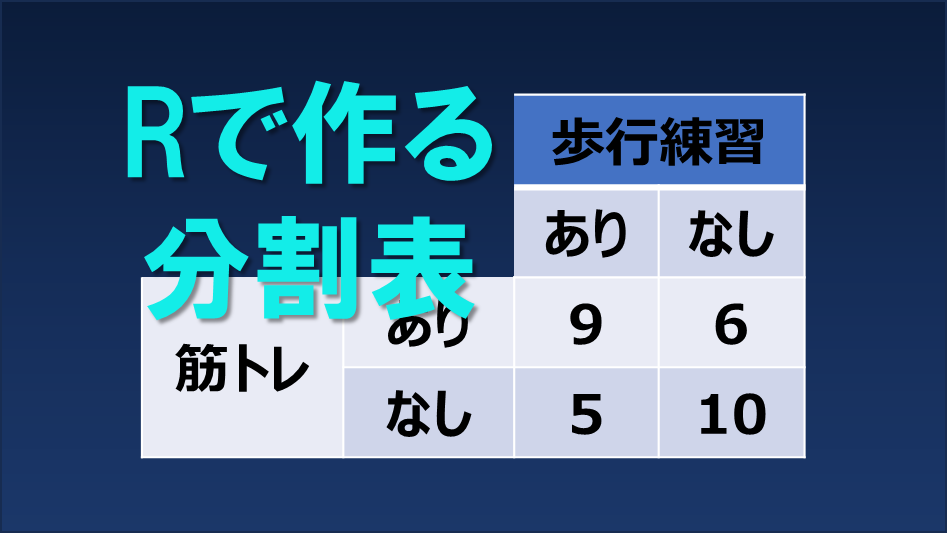
筋力トレーニング:musc(実施=yes、非実施=no)
歩行練習:gait(実施=yes、非実施=no)
効果:effect (あり=good、なし=not)
dat <- data.frame(
    c(rep("yes", 15),rep("no", 15)),
    c(rep("yes", 9), rep("no", 6), rep("yes", 5), rep("no", 10)),
    c(rep("good", 12), rep("not", 3), rep("good", 4), "not", "good", "good", rep("not", 8))
)
colnames(dat) <- c("musc", "gait", "effect")
head(dat)> head(dat)
musc gait effect
1 yes yes good
2 yes yes good
3 yes yes good
4 yes yes good
5 yes yes good
6 yes yes good1列目(筋トレ)と3列目(歩行練習)の分割表を作成
tab1 <- xtabs(
    ~musc + effect,
    data=dat
)
print(tab1)> print(tab1)
effect
musc good not
no 6 9
yes 12 3周辺合計
addmargins(tab1)> addmargins(tab1)
effect
musc good not Sum
no 6 9 15
yes 12 3 15
Sum 18 12 30行の入れ替え
tab1[c("yes","no"), ]> tab1[c("yes","no"), ]
effect
musc good not
yes 12 3
no 6 9行列の置換(転置)
t(tab1)> t(tab1)
musc
effect no yes
good 6 12
not 9 3歩行練習の有無で層別
tab2 <- xtabs( ~ musc + effect + gait, data = dat)
print(tab2)> print(tab2)
, , gait = no
effect
musc good not
no 2 8
yes 3 3
, , gait = yes
effect
musc good not
no 4 1
yes 9 0