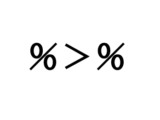
パッケージ
パケージのインストールで R を挫折する人もおられますので解説します。Rのパッケージは、関数やデータセットをまとめたもので、世界中の研究者から無償で提供されています。Rには「base」といったデフォルトで最初からインストールされているパッケージもありますが、追加のパッケージはCRAN(Comprehensive R Archive Network)を通してダウンロードすることができます。CRANはR言語のパッケージ、ソフトウェア、そして関連するドキュメントが集められ、配布されるネットワークで、全世界にミラーサイトが存在します。
パッケージの保存場所とパス指定
パッケージがどこに保存されるか確認してみます。Rを使用していくと、保存場所が数カ所存在する場合もあります。
.libPaths()Rの出力例
> .libPaths()
[1] "C:/Program Files/R/R-4.6.1/library"パッケージをダウンロードする前に、.libPaths()関数でパッケージの保管場所を指定されることを推奨します。Documentsに専用のフォルダ(例:Rpackages_4.6)を作成しても構いません…フォルダ名は何でも大丈夫です。Rに標準装備されているパッケージ(base)以外のパッケージを保管する場所になります。Rを更新した場合でも、同じ場所に保管しておくことで,これまでインストールしたパッケージを継続して使用することができます。
例として、DocumentsにRpackages_4.6というフォルダを作成して,パッケージを保管するフォルダに指定します。(biborokuはPCの名称)
.libPaths("C:\\Users\\biboroku\\Documents\\Rpackages_4.6")
.libPaths()[1] "C:/Users/biboroku/Documents/Rpackages_4.6"
[2] "C:/Program Files/R/R-4.6.1/library" WindowsのファイルパスをRの文字列として記述する場合は、区切り文字にスラッシュ(/)を使用できます。バックスラッシュを使用する場合は、2つ続けて(\\\)記述する必要があります。
"C:/Users/biboroku/Documents/Rpackages_4.6"
"C:\\Users\\biboroku\\Documents\\Rpackages_4.6"
これでパッケージの保管場所が指定できました。その後は、パッケージをダウンロードしたら、同じ場所に保管してくれます。
僕の保管フォルダ(Rpackages)の中を見てみます。いろいろなパッケージがあります。一度ダウンロードしたら次回からはダウンロードが不要です。
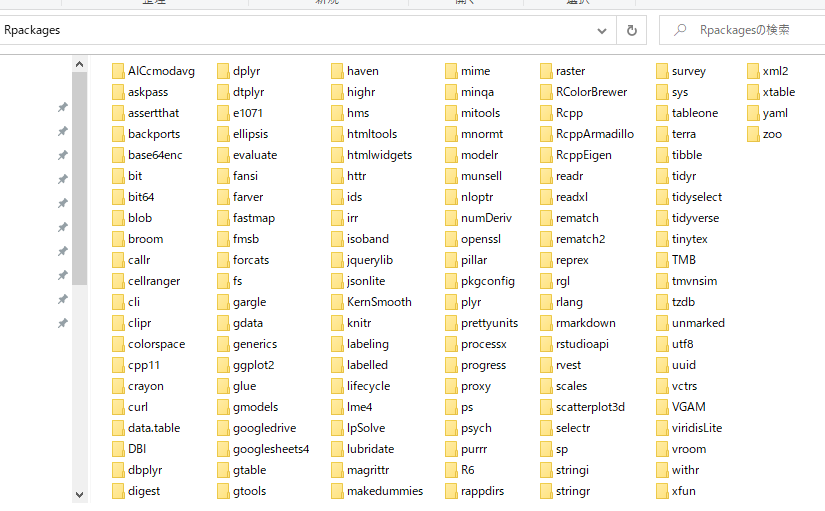
パッケージのダウンロード
それでは実際にパッケージをダウンロードしてみましょう。試しにdplyrというパッケージをCRANからダウンロードしてみます(dplyrを利用することで一覧表の操作が楽になります)。インストールは,install.packages()関数を使用します。下記のコードをペーストしてEnterをクリックするとダウンロードが始まります。
install.packages("dplyr")CRANはJapanを選択してOKをクリックしてください。最後にどこにインストールされたか表示されます。他のパッケージもインストールしたらここに追加されることになります。私の場合は常にデスクトップに置いておきたいので、インストール場所をデスクトップに指定します。Rのバージョンを変更したときも常に同じ場所にパッケージを保管しておけばすぐに使えます。また、他のPCで作業する場合もパッケージだけ持ち出すことパッケージを使用することができます(もちろん再度ダインロードしても構いません)。
パッケージを起動する library()関数
パッケージを使う場合は、library()関数 を使用します。
library(dplyr)これでパッケージdplyrが使える状態になります。プログラムのなかで :: の記号がある場合は、「このパッケージを使用してます」という意味です(記号::は、使用しなくても構いません)。ダウンロードした、パッケージdplyrを使用してみます。
ここをクリックしてdataをRに読み込んでください
data <- read.table(
  text = "
ID sex age BRS score treatment effect
6  M 67 6 16.5 B 4
3  F 70 6 19.3 B 3.3
7  M 71 5 19.6 B 0
18 F 65 6 20.9 B 3.3
14 M 63 5 21.8 B 4.1
9  F 65 6 22.2 A -1
12 M 75 5 22.3 B 3.3
13 F 72 5 22.4 B 3.3
1  F 81 5 22.5 B 2
17 F 75 6 23.3 B 5.1
15 M 72 6 24.7 A 5.5
2  F 69 6 25.5 A 7.8
4  F 82 5 25.6 A 9.6
8  M 79 5 26.3 A 8.6
16 M 71 5 28.5 B 5.5
11 M 82 5 28.6 A 8.6
10 F 77 4 29.6 A 6.1
5  M 85 5 31.2 A 10.8
19 M 88 4 33.3 A 11.1
20 M 86 4 35.0 A 12.2
",
  header = TRUE,
  stringsAsFactors = FALSE
)

# 読み込んだデータを表示
head(data)> head(data)
ID sex age BRS score treatment effect
1 6 M 67 6 16.5 B 4.0
2 3 F 70 6 19.3 B 3.3
3 7 M 71 5 19.6 B 0.0
4 18 F 65 6 20.9 B 3.3
5 14 M 63 5 21.8 B 4.1
6 9 F 65 6 22.2 A -1.0ダウンロードしたパッケージdplyrをlibrary()関数で起動します。
library(dplyr)treatmentAとBのage、scoreの平均および標準偏差を一気に出力します。group_by()で層別、summarise()で各層の要約を実行します。na.rm = TRUEは、欠損値を無視するための理論値です。.group = “drop” により、summarise()関数が保持しているグループ化を解除することができます。改めて、group_byで設定すれば問題はありません。
data %>%
  group_by(treatment) %>%
  summarise(
    age_mean = mean(age, na.rm = TRUE),
    age_sd = sd(age, na.rm = TRUE),
    score_mean = mean(score, na.rm = TRUE),
    score_sd = sd(score, na.rm = TRUE),
    .group = "drop"
)# A tibble: 2 × 6
treatment age_mean age_sd score_mean score_sd .group
<chr> <dbl> <dbl> <dbl> <dbl> <chr>
1 A 78.5 7.68 28.2 4.07 drop
2 B 71 5.27 21.7 3.13 drop 階層的な構造(入れ子)になっている値の要約
各treatmentの男性、女性の人数を一気に出力します。
data %>%
  group_by(treatment, sex) %>%
  summarise(
    count = n()  ,
    .groups = "drop"
)# A tibble: 4 × 3
treatment sex count
<chr> <chr> <int>
1 A F 4
2 A M 6
3 B F 5
4 B M 5