この検定を使う前に
対象は、互いに独立した2群の量的データです。各群の分布と外れ値を箱ひげ図やQ–Qプロットで確認し、とくに小標本では正規性からの大きな逸脱に注意します。正規性検定や等分散性検定で有意でなかったことだけでは、前提を満たす証明になりません。また、同じ人の前後比較やマッチングされたペアには、その依存関係に合った解析が必要です。
架空のデータを使って、独立した2群の母平均を比較する「対応のないt検定」を練習します。主に、母分散が未知で等しいと仮定するStudentのt検定を扱い、最後にWelchのt検定との違いを説明します。
例題)回復期病棟で3週間入院した脳卒中患者を対象とした。X病院の患者群をX群、Y病院の患者群をY群としてFIM利得を比較した。ここでは説明を簡単にするため、各患者の観測値は独立で、両群の母集団は正規分布に従い、母分散は等しいと仮定する。FIM利得は退院時FIMから入院時FIMを引いた値とする。なお、実際の病院間比較では患者背景や病院内の相関への配慮が必要であり、この単純な比較だけで病院の治療効果は判断できない。
データの準備と要約
このページのコードはRの標準機能だけで実行できます。追加パッケージは不要です。
次の固定データを入力し、X群とY群を別々の列に置いた横長データフレームを作ります。追加パッケージやCSVの読み込みは不要です。X群は28人、Y群は31人なので、X列の末尾にNAを3個補います。各行は対応する患者のペアを表すものではありません。
x <- c(11, 23, 20, 34, 31, 25, 22, 22, 25, 24,
       39, 33, 17, 14, 32, 27, 36, 27, 40, 22,
       35, 34, 8, 24, 1, 28, 13, 36)
y <- c(30, 26, 19, 39, 36, 47, 35, 27, 33, 23,
       25, 21, 32, 26, 18, 49, 20, 34, 24, 50,
       30, 28, 29, 36, 41, 30, 20, 35, 35, 33, 21)
n <- max(length(x), length(y))
data <- data.frame(
  X = c(x, rep(NA_real_, n - length(x))),
  Y = c(y, rep(NA_real_, n - length(y)))
)
head(data)> head(data)
X Y
1 11 30
2 23 26
3 20 19
4 34 39
5 31 36
6 25 47以降はdataXとdataYを直接使います。t.test()は各列のNAを個別に除きます。手計算でも各列でNAを除外します。行単位で欠測を削除すると、Y群の有効な値まで失うため注意してください。
# 列名と、各群の欠測でない値の個数を確認
names(data)
colSums(!is.na(data[c("X", "Y")]))> names(data)
[1] "X" "Y"
> colSums(!is.na(data[c("X", "Y")]))
X Y
28 31 # 横長データの各列から箱ひげ図を描く(NAは除外されます)
boxplot(data[c("X", "Y")],
names = c("X群", "Y群"),
ylab = "FIM利得", col = c("lightblue", "mistyrose"))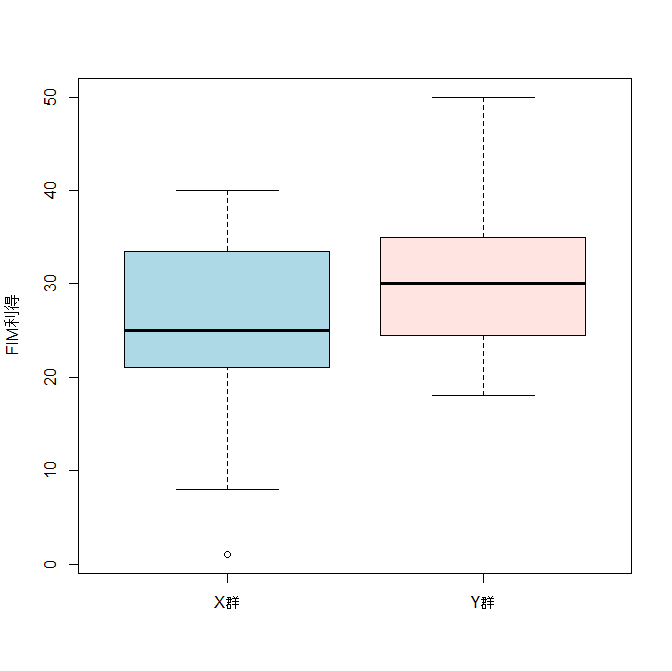
data$XでX列、data$YでY列を取り出せます。箱ひげ図、記述統計、t検定はいずれも横長のデータから直接実行できるため、縦長への変換は不要です。
各グループの記述統計
# 各列のNAを除いて記述統計を計算
summarize_group <- function(z) {
  z <- z[!is.na(z)]
  c(n = length(z), mean = mean(z), sd = sd(z),
    median = median(z), min = min(z), max = max(z))
}
base::t(sapply(data[c("X", "Y")], summarize_group)) n mean sd median min max
X 28 25.10714 9.696656 25 1 40
Y 31 30.70968 8.572023 30 18 50t検定
この例では等分散を仮定するStudentのt検定を行います(var.equal = TRUE)。標本の分散が完全に一致する必要はありません。帰無仮説は「X群とY群の母平均が等しい」、対立仮説は「母平均が異なる」です。両側検定、有意水準5%として検定します。
t.test(data$X, data$Y, var.equal=TRUE) Two Sample t-test
data: data$X and data$Y
t = -2.3557, df = 57, p-value = 0.02195
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
-10.3649066 -0.8401625
sample estimates:
mean of x mean of y
25.10714 30.70968 掲載データではX群の平均は25.11、Y群の平均は30.71、平均差(X − Y)は約−5.60です。両側検定のp値は約0.022で、5%水準で帰無仮説を棄却します。これは母平均の差を示す統計的な証拠ですが、臨床的な重要性や病院の治療効果を直接示すものではありません。
結果を報告するときは、各群の人数・平均・標準偏差、平均差と95%信頼区間、t値、自由度、p値を併記します。以下では、併合分散を使う理由と手計算の方法を確認します。