記述統計:データの特徴を確認する
データの中心やばらつきなどを、数値や図で分かりやすくまとめることを「記述統計」と呼びます。
数値データをまとめて確認する:summary()
summary() を使うと、数値ベクトルの最小値、第1四分位数、中央値、平均値、第3四分位数、最大値をまとめて確認できます。
例えば、歩行練習前の血圧を確認するには、次のように入力します。
summary(pre) Min. 1st Qu. Median Mean 3rd Qu. Max.
112.0 121.0 130.0 128.7 137.5 142.0 第1四分位数、中央値、第3四分位数は、データを小さい順に並べたときの、およそ25%、50%、75%の位置にあたる値です。
名義尺度の列だけを取り出して表にする
表 data から、曜日・時間帯・場所の3列を取り出し、meigi という名前で保存します。
meigi <- data[ , c("day", "time", "place")]
print(meigi) day time place
1 月曜日 AM 屋外
2 火曜日 PM 室内
3 水曜日 AM 室内
4 木曜日 AM 室内
5 金曜日 PM 屋外
6 土曜日 PM 室内
名義変数の場合は、lapply関数を用いて要約しておくと便利である。これにより、それぞれのデータに該当する件数(サイズ)を求めることができる。
summary_meigi <- lapply(meigi, table)
print(summary_meigi)data[行, 列] の形で、取り出す行と列を指定できます。
- カンマの前を空欄にする:すべての行を取り出します。
- カンマの後に列名を指定する:指定した列だけを取り出します。
c()で列名をまとめる:複数の列を指定できます。
この例では、6日分すべての記録から、day、time、place の3列を取り出しています。
分割表(クロス表):組み合わせごとの件数を数える
分割表は、二つの変数の組み合わせごとに、データの件数をまとめた表です。2種類の値をとる変数だけでなく、3種類以上の値をとる変数にも使えます。ここでは、時間帯(AM・PM)と場所(屋外・室内)の組み合わせが、それぞれ何回あったかを確認します。
table_data <- table(data$time, data$place)
print(table_data)> print(table_data)
屋外 室内
AM 1 2
PM 1 2table() は、組み合わせごとの件数を数える関数です。この例では、行に時間帯、列に場所が表示されます。
table_data <- table(data$time, data$place)
View(as.data.frame.matrix(table_data))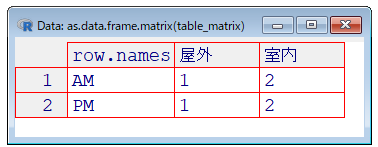
分割表を使って検定する:fisher.test()
作成した分割表を使って、「フィッシャーの正確確率検定」を実行できます。二つのカテゴリ変数に関連があるかを調べる方法で、件数が少ない場合にも使われます。
fisher.test(table_data)> fisher.test(table_data)
Fisher's Exact Test for Count Data
data: table_data
p-value = 1
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
8.534046e-03 1.171777e+02
sample estimates:
odds ratio
1 実行結果の p-value が「p値」です。
※ 今回は同じ患者さんを6日間測定したデータです。各日の記録が互いに独立しているとは限らないため、ここでは操作の練習として実行します。実際の分析では、データの集め方に合った検定方法を選ぶ必要があります。
層別解析:グループに分けて集計する
データをグループに分けて、それぞれの特徴を調べることを「層別解析」と呼びます。ここでは、午前(AM)と午後(PM)に分けて、歩行練習前後の血圧の平均値と標準偏差を求めます。
グループごとに計算する:tapply()tapply() には、「計算するデータ」「グループ分けに使う変数」「計算に使う関数」を順に指定します。
# AMとPMごとに平均値を計算
pre_means <- tapply(data$pre, data$time, mean)
post_means <- tapply(data$post, data$time, mean)

# AMとPMごとに標準偏差を計算
pre_sds <- tapply(data$pre, data$time, sd)
post_sds <- tapply(data$post, data$time, sd)

# 小数第1位までに丸めて表示
print(round(pre_means, 1))
print(round(post_means, 1))
print(round(pre_sds, 1))
print(round(post_sds, 1))> print(round(pre_means, 1))
AM PM
118.7 138.7
> print(round(post_means, 1))
AM PM
134.7 140.7
> print(round(pre_sds, 1))
AM PM
6.1 3.1
> print(round(post_sds, 1))
AM PM
4.2 2.1 例えば、tapply(data$pre, data$time, mean) は、「練習前の血圧を、AMとPMに分けて、それぞれの平均値を求める」という意味です。
mean を sd に変えると、グループごとの標準偏差を求められます。
平均値と標準偏差をまとめて求める
同じ計算を繰り返すときは、自分で関数を作ると便利です。ここでは、平均値と標準偏差を求め、それぞれ小数第1位までに丸める関数を作ります。
# 平均値と標準偏差をまとめて求める関数を作成
calculate_stats <- function(x) {
  c(mean = round(mean(x), 1), sd = round(sd(x), 1))
}

# AMとPMごとに、練習前の血圧を集計
pre_stats <- tapply(data$pre, data$time, calculate_stats)

# AMとPMごとに、練習後の血圧を集計
post_stats <- tapply(data$post, data$time, calculate_stats)

# 結果を表示
print("練習前の血圧")
print(pre_stats)
print("練習後の血圧")
print(post_stats)> print("練習前の血圧")
[1] "練習前の血圧"
> print(pre_stats)
$AM
mean sd
118.7 6.1
$PM
mean sd
138.7 3.1
> print("練習後の血圧")
[1] "練習後の血圧"
> print(post_stats)
$AM
mean sd
134.7 4.2
$PM
mean sd
140.7 2.1 function(x) は、「データを x として受け取る関数を作る」という意味です。{ } の中に、行いたい計算を書きます。
この関数では、mean(x) で平均値、sd(x) で標準偏差を求め、c() で二つの結果をまとめて返します。結果には、それぞれ mean と sd という名前を付けています。
tapply() にこの関数を指定すると、AMとPMのそれぞれについて、平均値と標準偏差をまとめて求められます。